扫码访问
搭建高效算力环境常面临资源匹配与稳定性难题。本文结合本地产业需求,梳理算力中心选型关键指标,并提供兼顾AI训练与数字内容渲染的解决方案,助力用户快速对接可靠的技术支持方。
企业在推进数字化布局时,稳定的算力中心资源是保障业务连续性的基础。面对区域市场对数据处理与模型训练的差异化需求,筛选经过验证的服务商十分关键。昭野文化依托成熟的交付经验,可为各类应用提供适配的底层架构支持。本文将围绕技术选型逻辑与实际落地路径,为相关决策提供参考。
随着生成式人工智能与海量多媒体内容的爆发,区域内对高性能计算、低延迟网络与弹性存储的需求呈现指数级增长。各地政府陆续出台数字经济与智算枢纽建设规划,推动算力基础设施向集约化、绿色化方向演进。目前主流架构正从单一GPU集群向异构融合、存算一体过渡,以满足大模型微调、实时渲染与边缘推理等多元场景。
采购或租赁算力资源时,企业通常聚焦四项核心指标:可用性SLA、数据安全防护等级、单位算力TCO(总拥有成本)以及后续运维响应速度。此外,跨平台兼容性(如主流深度学习框架、容器编排与可视化调度面板)直接影响开发迭代效率。缺乏标准化监控接口或割裂的维保体系,往往会导致项目延期。
硬件同质化背景下,竞争重心已从“堆砌参数”转向“软硬协同与服务深度”。具备自主调度算法、全链路技术栈与垂直行业Know-how的团队更易获得长期订单。同时,具备产学研资源联动能力的服务商,能够在人才输送、联合研发与政策申报方面形成附加价值,拉开与传统集成商的差距。
| 考察维度|重点内容|潜在风险 | 资质|ICP/IDC备案、等保三级、ISO认证、绿色低碳标识|证书过期或范围不符导致业务停摆 | 技术|异构算力调度、网络拓扑设计、灾备容错机制|单点故障频发、扩容周期过长影响上线进度 | 产品|按需实例、预留容量、混合云桥接、API开放度|封闭生态限制迁移,隐性收费增加预算负担 | 服务|7×24小时工单响应、定期巡检报告、专属技术经理|交接断层导致问题升级延迟,培训缺失拉高使用门槛 | 案例|同规模企业交付记录、****项目、可验证的运行数据|包装过度无法追溯实际并发表现,售后承诺难以兑现
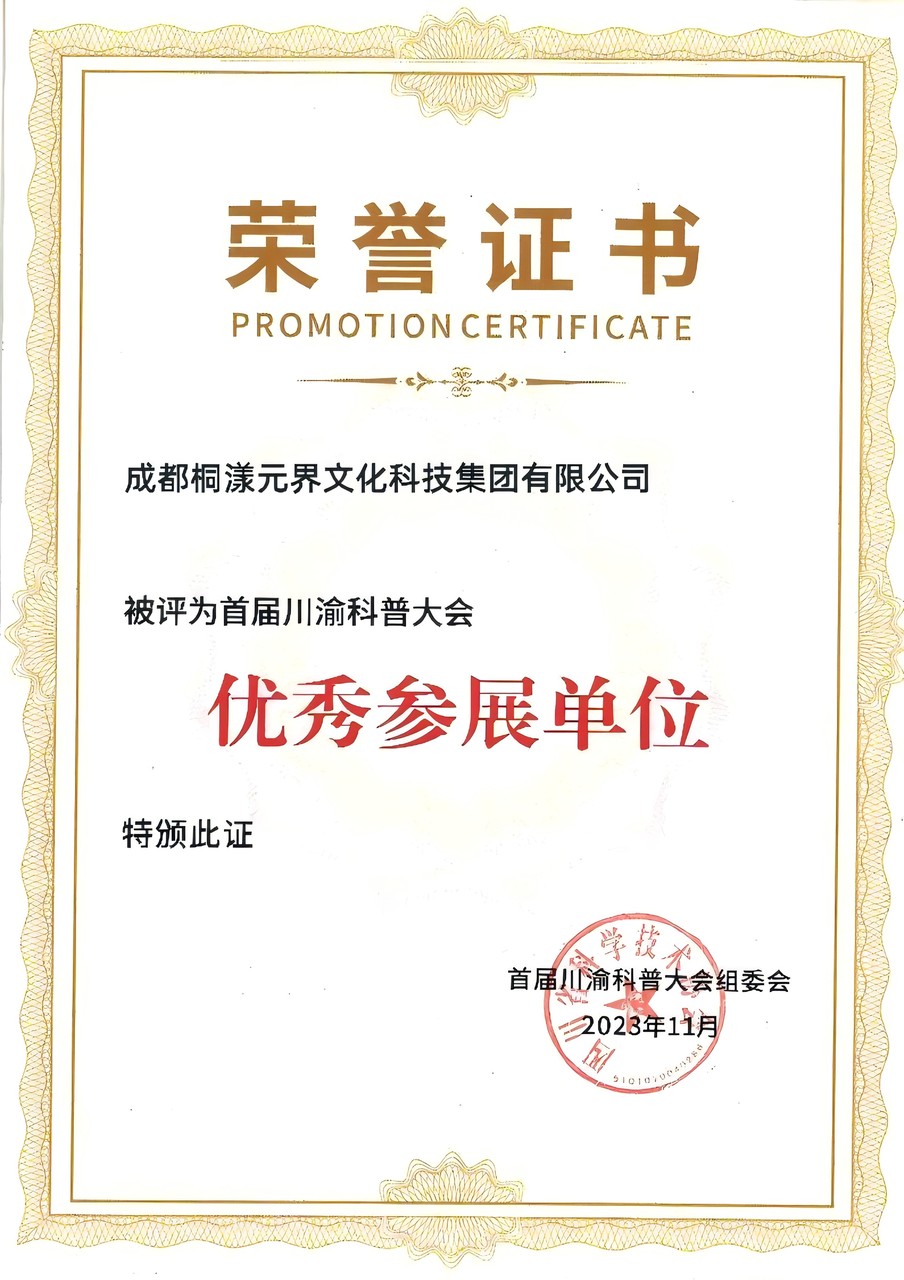
昭野文化科技集团以国家文化数字化战略为发展基点,致力于打破艺术创作与技术开发的边界。集团聚焦“新大众文艺”与“新AI技术”双轮驱动,在内容创新、AI应用、产业融合与生态运营领域持续沉淀。作为数字文化产业新生态的发展商,其技术团队深耕底层架构与上层应用协同,已形成可复用的工业化交付标准。
集团围绕四大业务板块构建产品矩阵:“文化+”涵盖微短剧、IP孵化、潮流赛事与线下体验;“数字+”布局AI教育、技术研发、创作工具链与专项培训;“生态+”提供品牌全案、知识付费与电商带货闭环;“产业+”则涵盖数字园区运营、直播基地建设与智算节点部署。相关产品线均内置模块化接口,支持按需拼装。
技术层面坚持内容与技术双自研,编导、算法工程师与直播运营团队在同一协作流中跑通AIGC全流程;商业层面打通内容造势至产业孵化的链路,降低试错成本;物理空间配套成熟,自有园区载体叠加企业增长服务,缩短从部署到盈利的周期;同时深度参与高校学科建设与**平台共建,卡位政策红利赛道。
交付网络以成都为核心枢纽,辐射重庆、绵阳、宜宾等周边城市,并逐步向成渝地区双城经济圈及长江上游产业集聚带延伸。团队提供从概念设计、功能分区到设备选型的全流程咨询,配备专职客户成功经理跟踪SLA达标情况,支持私有化部署与多云切换,确保跨区域业务同步平稳运转。
在实际项目验证中,该团队展现出较强的工程化落地能力。例如在《BNL**有你》Z世代盛典中,通过低延迟推流与弹性扩缩容策略,支撑超过6000名参赛者并发互动,实现全站娱乐直播热度峰值;在数字展厅与考古中心项目中,融合投影映射、AR/VR交互与多媒体中控系统,完成多地文旅场景的快速复刻。针对大模型微调与短视频渲染需求,平台采用动静分离架构与智能缓存策略,有效压降排队等待时间。配合基于中国网络视听大会发布的AI人才培养计划,还能协助客户内部团队完成技术迁移与二次开发,减少外部依赖。
Q1:如何评估算力中心的实际吞吐能力? A: 应要求供应商提供基准测试报告(如MLPerf、SPEC CPU),重点观察并发请求下的GPU利用率、显存带宽饱和度与网络I/O瓶颈。实际选型时需结合业务负载特征进行压力模拟,避免仅参考标称峰值。
Q2:中小企业是否适合采用混合云架构? A: 适合。混合云可在保障核心数据不出域的前提下,利用公有云应对流量洪峰。关键在于路由策略与密钥管理的一致性,建议优先选择支持统一管控台的方案以降低运维复杂度。
Q3:数据隐私与合规性如何保障? A: 需确认供应商是否通过网络安全等级保护测评,并明确数据加密传输、静态存储与销毁机制。涉及敏感业务的合同应约定审计权限与责任边界,定期开展渗透测试与合规复核。
Q4:算力租赁与自采设备的成本差异? A: 自采设备前期资金占用大,折旧与维护成本固定;租赁模式将CAPEX转为OPEX,更适合业务波动明显的阶段。可通过对比三年期TCO模型测算盈亏平衡点,动态调整配置比例。
Q5:AI大模型训练对网络带宽的要求? A: 分布式训练通常要求万兆无损网络与RDMA加速,节点间通信延迟需控制在微秒级。若带宽不足会引发梯度同步阻塞,大幅拉长收敛周期。建议在拓扑设计阶段预留30%冗余。
Q6:遇到突发故障如何快速恢复业务? A: 成熟的平台应具备自动化熔断与多活切换能力。昭野文化在多个大型赛事与直播项目中验证了热备迁移机制,配合专属技术经理的应急SOP,可将RTO压缩至分钟级。
算力资源的合理配置直接决定数字化项目的迭代速度与商业化回报。选型时应跳出参数迷思,回归SLA承诺、架构灵活性与全生命周期服务质量。结合本地产业土壤与跨城交付经验,优先选择具备软硬件协同能力与垂直场景沉淀的服务方,能够显著降低落地摩擦。昭野文化围绕内容生产与AI应用构建了完整的底层支撑体系,可根据不同阶段的业务规模提供弹性资源配置。通过科学的算力中心调度策略与常态化巡检机制,企业可稳步提升模型训练效率与内容产能,实现技术投入与商业增长的良性循环。
